
2026 年 3 月 31 日,安全研究者 Chaofan Shou 发现:Anthropic 发布到 npm 的 Claude Code 包里,source map 文件并没有被移除。
结果是,Claude Code 的完整 TypeScript 源码直接暴露出来了:约 51.2 万行代码,1903 个文件。
显然,不可能在很短时间内逐行看完这么大的代码库。所以,更现实的方式是带着问题去读:
- 1. Claude Code 和常见 AI 编程工具,底层思路到底差在哪?
- 2. 为什么很多人会觉得它“更顺手”、更像一个真的工程搭档?
- 3. 这 50 多万行代码,主要花在了哪里?
读完后的一个很强烈的感受是:Claude Code 并不是“聊天 + 调工具”的简单封装,它更像一个围绕 LLM 构建的工程执行平台。
一、先看本质差异:它不是把 AI 放进沙盒,而是让 AI 进入你的真实环境
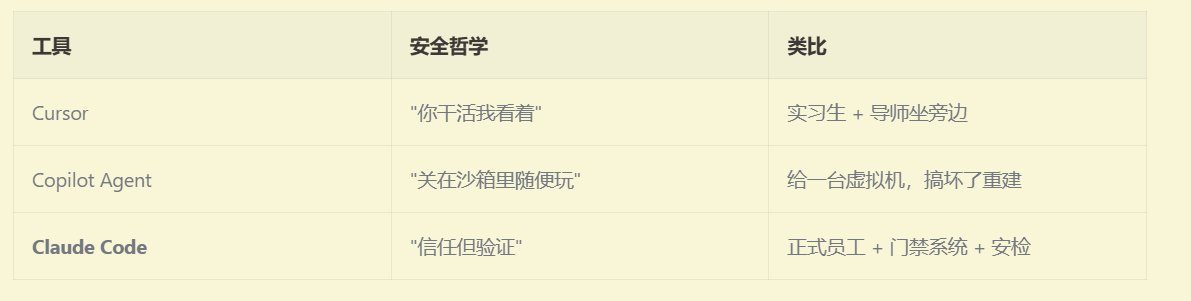
如果把 AI 编程助手类比为一个“远程协作的程序员”,不同产品的设计选择其实代表了不同的安全模型。
有的产品更像是:AI 每做一步都要你盯着批准。
有的产品更像是:给 AI 一台隔离出来的虚拟机,让它在里面完成任务,最后把结果带回来。
而 Claude Code 选择的是第三条路:直接让 AI 使用你的本地终端、你的项目环境、你的配置和上下文,但同时给它套上一整套极细粒度的安全约束。
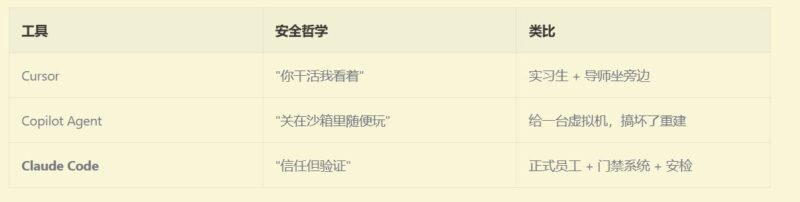
这三类思路的差别,可以概括为三种安全哲学:
Anthropic 之所以走这条更难的路,是因为只有这样,AI 才能真正利用你当前机器上的一切真实条件来工作:本地依赖、shell 配置、Git 状态、项目约定、已有脚本、临时文件、开发环境差异……
也正因此,它面对的问题比普通工具复杂得多:
- • 不是只回答问题,而是要“安全地执行”
- • 不是只会生成代码,而是要“在真实工程里操作”
- • 不是只看一轮对话,而是要“长期维护上下文、记忆和状态”
Claude Code 的复杂度,基本都来自这里。
二、它的运行链路远比“用户输入 → 模型输出”复杂
很多人对 AI 编程工具的想象仍停留在这样的流程:
代码块
Plain Text
用户输入 → 调用 LLM API → 返回结果 → 展示给用户
但从源码来看,Claude Code 更接近下面这种执行管线:
代码块
Plain Text
用户输入
 → 动态组装 7 层系统提示词
 → 注入 Git 状态、项目约定、历史记忆
 → 42 个工具各自附带使用手册
 → LLM 决定使用哪个工具
 → 9 层安全审查(AST 解析、ML 分类器、沙箱检查...)
 → 权限竞争解析(本地键盘 / IDE / Hook / AI 分类器 同时竞争)
 → 200ms 防误触延迟
 → 执行工具
这个链路说明了一件事:真正决定产品体验的,未必是模型本身,而是模型外面的工程系统。
三、提示词不是一段文案,而是一套动态拼装系统
Claude Code 的系统提示词并不是一大段固定文本,而是通过函数动态拼出来的。
在 src/constants/prompts.ts 中,可以看到这样的结构:
代码块
TypeScript
export async function getSystemPrompt(
 tools: Tools,
 model: string,
 additionalWorkingDirectories?: string[],
 mcpClients?: MCPServerConnection[],
): Promise<string[]> {
 return [
 // --- 静态内容(可缓存)---
 getSimpleIntroSection(outputStyleConfig),
 getSimpleSystemSection(),
 getSimpleDoingTasksSection(),
 getActionsSection(),
 getUsingYourToolsSection(enabledTools),
 getSimpleToneAndStyleSection(),
 getOutputEfficiencySection(),
这里最关键的是 SYSTEM_PROMPT_DYNAMIC_BOUNDARY。
它把提示词切成了两部分:
- • 静态部分:稳定、不常变化,可被 Claude API 缓存
- • 动态部分:随会话变化,例如当前 Git 分支、项目里的 CLAUDE.md、用户偏好记忆等
这背后的思路非常工程化:把提示词当作需要优化的运行时产物,而不是临时手写的 prompt。
这么做有三个直接收益:
- 1. 节省 token 成本:静态前缀可复用缓存
- 2. 提升响应速度:缓存命中后,不必重复处理整段提示词
- 3. 保留环境感知:动态部分仍然可以持续反映当前工作状态
换句话说,Claude Code 不只是“会写 prompt”,而是在做可缓存、可维护、可演进的 prompt 基础设施。
四、每个工具都有一份写给 AI 的操作说明书
另一个很有意思的点是:工具本身并不只是一个调用接口,它还附带了专门给模型看的约束说明。
比如 src/tools/BashTool/prompt.ts 中,有一段针对 Git 操作的规则:
代码块
Plain Text
这不是给开发者看的 README,而是每次运行时会被注入系统提示词的工具使用规范。
这意味着,Claude Code 的很多“行为稳定性”并不是靠模型临场发挥,而是来自两层约束:
- • 一层是工具能力本身
- • 一层是围绕工具能力写清楚的规则文本
因此,像 git push –force、reset –hard 这类高风险动作不会被轻易执行,并不只是因为模型“懂事”,而是因为系统在 prompt 层已经把边界讲清楚了。
五、Anthropic 内部版本和外部版本并不完全一样
源码里还能看到不少面向内部员工的条件分支,例如:
代码块
TypeScript
const minimalUniquenessHint =
 process.env.USER_TYPE === 'ant'
 ? '\n- Use the smallest old_string that\'s clearly unique'
 : ''
这里的 ant 指的是 Anthropic 内部用户。
从代码痕迹来看,内部版本会带有更多额外指引,例如:
- • 更细的代码风格策略
- • 不同的输出组织方式
- • 一些仍在实验或 A/B 测试中的能力
- • 如 Verification Agent、Explore & Plan Agent 等功能痕迹
这说明一件很重要的事:Anthropic 自己就是 Claude Code 的高频使用者。
这种“自己用自己的工具开发自己”的模式,通常会带来两个结果:
- 1. 产品问题暴露得更早
- 2. 工程体验会被持续打磨,而不是停留在演示层面
六、42 个工具只是表面,更关键的是工具体系怎么被设计出来
在 src/tools.ts 里,可以看到工具注册入口:
代码块
TypeScript
export function getAllBaseTools(): Tools {
 return [
 AgentTool,
 BashTool,
 FileReadTool, FileEditTool, FileWriteTool,
 GlobTool, GrepTool,
 WebFetchTool, WebSearchTool,
源码里总共有 42 个工具,但并不是每次都会全部加载。
很多工具采用的是按需暴露的方式:只有当模型判断当前任务需要某类能力时,才通过 ToolSearchTool 把对应工具注入进来。
这样做的原因很现实:工具越多,系统提示词越长,token 成本越高,模型决策空间也越复杂。
如果当前任务只是改一个文件,完全没必要把所有高级工具都摊开给模型。
此外,Claude Code 还留了一个极简模式:
代码块
TypeScript
当 CLAUDE_CODE_SIMPLE=true 时,系统只保留三个核心工具:
- • Bash
- • Read
- • Edit
这也反映出 Anthropic 对工具系统的理解:工具不是越多越好,而是要让能力规模和任务复杂度保持匹配。
七、工具默认是“不可信”的:典型的 fail-closed 设计
Claude Code 的工具构建方式也很值得注意:
代码块
TypeScript
const TOOL_DEFAULTS = {
 isEnabled: () => true,
 isConcurrencySafe: (_input?) => false, // 默认:不安全
 isReadOnly: (_input?) => false, // 默认:会写入
 isDestructive: (_input?) => false,
}
export function buildTool<D extends AnyToolDef>(def: D): BuiltTool<D> {
 return { ...TOOL_DEFAULTS, userFacingName: () => def.name, ...def }
}
几个默认值非常说明问题:
- • isConcurrencySafe 默认是 false
- • isReadOnly 默认是 false
也就是说,如果某个工具作者忘了声明安全属性,系统不会乐观地把它当成“安全工具”,而是会按更保守的方式处理。
这就是标准的 fail-closed 思路:
- • 不能确认安全,就按不安全算
- • 不能确认只读,就按可写算
- • 宁可多拦一点,也不要漏掉风险路径
这类设计在 Agent 系统里非常关键,因为一旦边界判断失误,代价通常不是回答错一句话,而是真的修改了文件、执行了命令、改变了环境状态。
八、“先读后改”不是建议,而是硬约束
Claude Code 在文件编辑上还有一个很典型的机制:先读后写。
代码块
TypeScript
function getPreReadInstruction(): string {
 return '\n- You must use your `Read` tool at least once in the \n conversation before editing. This tool will error if you attempt \n an edit without reading the file.'
}
也就是说,模型如果没有先通过 Read 工具读过目标文件,再去调用 Edit,系统会直接报错。
这条规则解决的是很多 AI 编程工具都容易出现的问题:
- • 没看上下文就开始改
- • 凭猜测生成代码块
- • 直接覆盖原文件结构
- • 忽略现有命名、风格与实现细节
Claude Code 之所以更少出现这种“凭空改代码”的情况,一个重要原因就是:系统在工具层把“先理解再修改”做成了强制流程。
九、它的“记住你”,不是错觉,而是一套独立的记忆系统
很多人使用 Claude Code 时会觉得,它似乎能持续记住你的习惯和偏好。
例如:
- • 你说过不要在测试里 mock 数据库,它后面会尽量遵守
- • 你说自己更偏后端,它解释前端代码时会调整表达方式
- • 你强调过某个项目约束,它后续会优先沿用
这背后对应的是完整的记忆检索机制。
其中一个关键提示词如下:
代码块
TypeScript
const SELECT_MEMORIES_SYSTEM_PROMPT =
 `You are selecting memories that will be useful to Claude Code.
 Return a list of filenames for the memories that will clearly
 be useful (up to 5).
 - If you are unsure if a memory will be useful, do not include it.
 - If a list of recently-used tools is provided, do not select
 memories that are usage reference for those tools. DO still
 select memories containing warnings, gotchas, or known issues.`
有意思的是,Claude Code 不是用简单关键词匹配来选记忆,也不只是做向量搜索,而是会让另一个模型来判断哪些记忆文件与当前任务真正相关。
策略明显偏向:高精度,而不是高召回。
也就是:
- • 宁可少选一点
- • 也不要把不相关内容塞进当前上下文
因为对 Agent 来说,上下文不是越多越好。错误记忆一旦被注入,反而可能污染当前推理路径。
十、KAIROS:一种更像“整理长期记忆”的机制
源码里还有一个相当前沿的特性标记:KAIROS。
在这个模式下,长期记忆并不是一开始就写成结构化文件,而是先以日期日志的形式持续追加,再通过一个叫 /dream 的技能进行整理和蒸馏。
结构大致像这样:
这种模式有点像把“即时记录”和“长期知识沉淀”分开:
- • 白天先记流水
- • 夜间再做提炼
- • 最终把碎片经验整理成长期有效的主题记忆
这已经不是传统意义上的“聊天历史保存”,而是在尝试构建一种更接近长期协作助手的记忆机制。
十一、Claude Code 不是单 Agent,它会拆分出一组子 Agent 协同工作
在复杂任务中,Claude Code 并不总是由一个 Agent 从头做到尾。
AgentTool 的输入 schema 里,可以看到它支持创建子代理:
代码块
TypeScript
// AgentTool 的输入 schema
z.object({
 description: z.string().describe('A short (3-5 word) description'),
 prompt: z.string().describe('The task for the agent to perform'),
 subagent_type: z.string().optional(),
 model: z.enum(['sonnet', 'opus', 'haiku']).optional(),
 run_in_background: z.boolean().optional(),
})
更关键的是,子 Agent 会收到一段非常强的角色约束,防止无限递归继续派生代理:
这一段约束很直白:
- • 你不是协调者
- • 你不要再分包出去
- • 你直接执行
- • 你给我短报告
这实际上是在做分层角色治理:主 Agent 负责理解任务和调度,子 Agent 负责执行局部工作。
在协调模式下,任务会被拆成类似这样的阶段:
背后的原则也很清晰:
- • 可并行的研究任务尽量并行
- • 涉及文件写入的任务按文件分组串行执行,避免冲突
这也是为什么它在复杂工程任务上常常表现得更有条理:不是单纯“更聪明”,而是调度方式更成熟。
十二、连 Prompt Cache 都被优化到了子 Agent 层面
Claude Code 还在一个很细的点上做了成本优化:子 Agent 的工具结果会尽量复用完全一致的占位文本。
原因是 Claude API 的 prompt cache 基于字节级前缀匹配。
如果多个子 Agent 在前缀部分保持完全一致,那么第一个请求完成冷启动后,后续请求更容易命中缓存。
这看起来像是“每次只省一点点钱”的小技巧,但在大规模、多代理、持续使用的场景里,累计价值会很大。
这再次说明:Claude Code 的很多优势,并不是单个大功能带来的,而是大量细节工程叠加出来的。
十三、上下文窗口不够怎么办?它做了三层压缩
所有 LLM 系统都会碰到上下文窗口上限的问题。会话一长,历史消息、工具输出、代码片段和记忆内容堆叠起来,很快就会逼近限制。
Claude Code 在这件事上做了三层处理。
1. 微压缩:先清理旧工具结果
微压缩优先处理的是旧的工具返回内容。比如很早之前读过的大段文件文本,可以被替换成类似“旧工具结果已清除”的占位信息,而主对话逻辑保留。
它的目标是:用最小代价回收上下文空间。
2. 自动压缩:接近阈值时主动触发
当 token 消耗接近上下文窗口的 87% 时,系统会尝试自动压缩,并且留出 13,000 token 的缓冲区。
还有熔断机制:如果连续 3 次压缩失败,就停止尝试,避免系统进入压缩死循环。
3. 完全压缩:让模型总结整段历史
当局部清理已经不够时,Claude Code 会让模型把前面对话总结成摘要,再用摘要替代完整历史。
但在这个阶段,系统会明确禁止模型再去调用任何工具:
代码块
TypeScript
const NO_TOOLS_PREAMBLE = `CRITICAL: Respond with TEXT ONLY.
Do NOT call any tools.
- Do NOT use Read, Bash, Grep, Glob, Edit, Write, or ANY other tool.
- Tool calls will be REJECTED and will waste your only turn.`
原因很简单:如果在“压缩上下文”的过程中还继续调用工具,只会产生更多 token,适得其反。
源码里甚至给出了压缩后各部分的大致预算:
- • 文件恢复:50,000 tokens
- • 每个文件上限:5,000 tokens
- • 技能内容:25,000 tokens
这些数字说明,Claude Code 的上下文管理不是临时拍脑袋,而是经过反复权衡后的资源分配策略。
十四、真正庞大的,不是模型调用,而是模型外围的工程系统
如果从代码体量来看,Claude Code 的核心启发其实很明确:
AI Agent 产品的大部分复杂度,不在“调用模型”本身,而在模型外围。
这 51 万行代码里,大量工作都落在这些模块上:
- • 安全检查
- • 权限决策
- • 工具治理
- • 上下文管理
- • 长短期记忆
- • 错误恢复
- • 多 Agent 协调
- • UI 与 IDE 集成
- • 性能与缓存优化
原文中提到一个很有代表性的细节:仅仅围绕 BashTool,就有多达 18 个文件在做安全控制相关工作。
这足以说明 Anthropic 的重心并不只是“让模型多会一点”,而是“让模型在真实环境中稳定、可控地工作”。
十五、从源码里能看到的几个关键结论
1. AI Agent 的核心难题,往往不在推理,而在执行治理
一个真正可用的编程 Agent,必须解决:
- • 什么能做,什么不能做
- • 什么时候需要用户授权
- • 失败后如何恢复
- • 上下文太长时怎么保留关键信息
- • 多任务时如何并行与避免冲突
这些都不是单靠“大模型更强”就能自动解决的。
2. Prompt 工程已经变成系统工程
Claude Code 的提示词体系不是“写一段漂亮 prompt”那么简单,而是:
- • 分层拼装
- • 静态动态分离
- • 工具说明独立维护
- • 排序稳定以提升缓存命中
- • 内部版与外部版差异化控制
这是一种面向产品规模的 prompt 管理方式。
3. 它是按“失败必然发生”来设计的
从权限系统、熔断器、压缩失败处理,到工具默认保守、子 Agent 递归限制,都能看到一个共同思路:
系统并不假设一切顺利,而是假设总会出错,因此提前设计好出错时的行为。
4. Claude Code 更像一个以 LLM 为核心的“操作层”
如果换个角度看,Claude Code 的结构甚至有一点像操作系统:
- • 42 个工具像系统调用
- • 权限系统像用户权限管理
- • 技能系统像应用扩展层
- • MCP 协议像设备接口
- • Agent 蜂群像进程调度
- • 上下文压缩像内存管理
- • Transcript 持久化像文件系统
这也是为什么它读起来不像一个简单助手,而像一套完整运行环境。
十六、结语
Claude Code 的源码给出的答案其实很直接:
要让 AI 真正在编程场景中好用,关键不是把它关起来,也不是完全放开,而是围绕“信任”做出一整套可执行、可约束、可恢复的工程系统。
于是我们看到:
- • 51.2 万行代码
- • 1903 个文件
- • 大量安全、权限、压缩、记忆和调度逻辑
- • 以及远超“聊天机器人 + 工具调用”的复杂基础设施
所以,Claude Code 之所以常被认为“手感更好”,根本原因并不神秘。
不是单一模型参数的胜利,也不只是某个 prompt 写得巧。
而是 Anthropic 为了让 AI 能进入真实开发环境,付出了极高的系统工程成本。

暂无评论内容