
作为一个Claude Code的深度用户,我一直被它没有记忆的事情折磨着。
每开一个对话,我都得想办法告诉它我是谁、我在做什么项目、现在的进度是什么样子的,每次都得跟AI讲半天背景是什么,这样才能让它不跑偏。
之前在研究龙虾源码的时候,发现龙虾的记忆逻辑做的蛮有趣的,我参考着龙虾的记忆思路,给我自己的Claude Code做了一套记忆系统。
我希望通过这套记忆系统,能够让我的AI搭子真正的记住我。
记住我在做的项目、记住我的决策习惯、记住我每天的进步,从一个每次都要重新认识我的新同事,变成一个越用越懂我的搭档。
这套系统我自己用了两周多了,效果还蛮不错的,今天来和大家分享一下~
案例分享
1. 待办助手:它比我更清楚今天该干嘛
打开电脑后,我不用再先回忆昨天做了什么、今天要干什么,直接问一句:今天我们做什么?
它会从昨天的记忆里把事情拉出来:哪篇文章要改稿、哪些流程还没测完、上次讨论到哪个环节了。
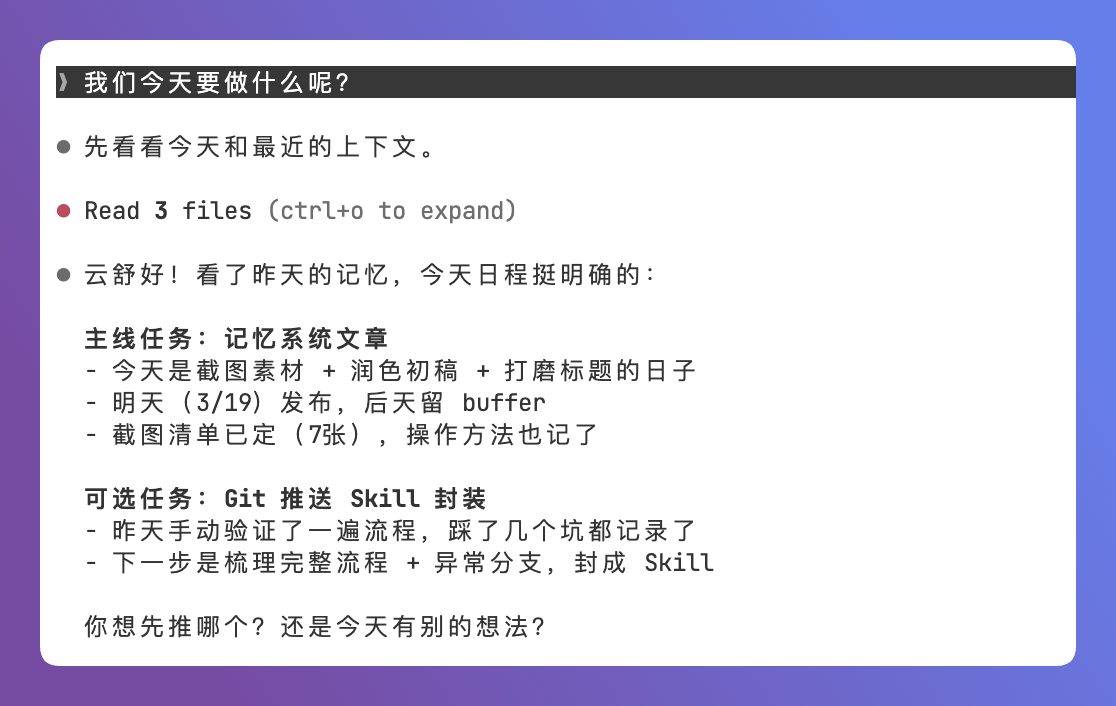
不需要我回忆昨天干了什么,它记得比我清楚。有时候我自己都忘了某件事还没做完,它会提醒我。
这套逻辑不仅适用于日常工作区,对于写代码也非常有帮助。
在我的CodePal编程工区里,AI也会及时提醒我的技术债和bug问题,免得过两天我就忘了。
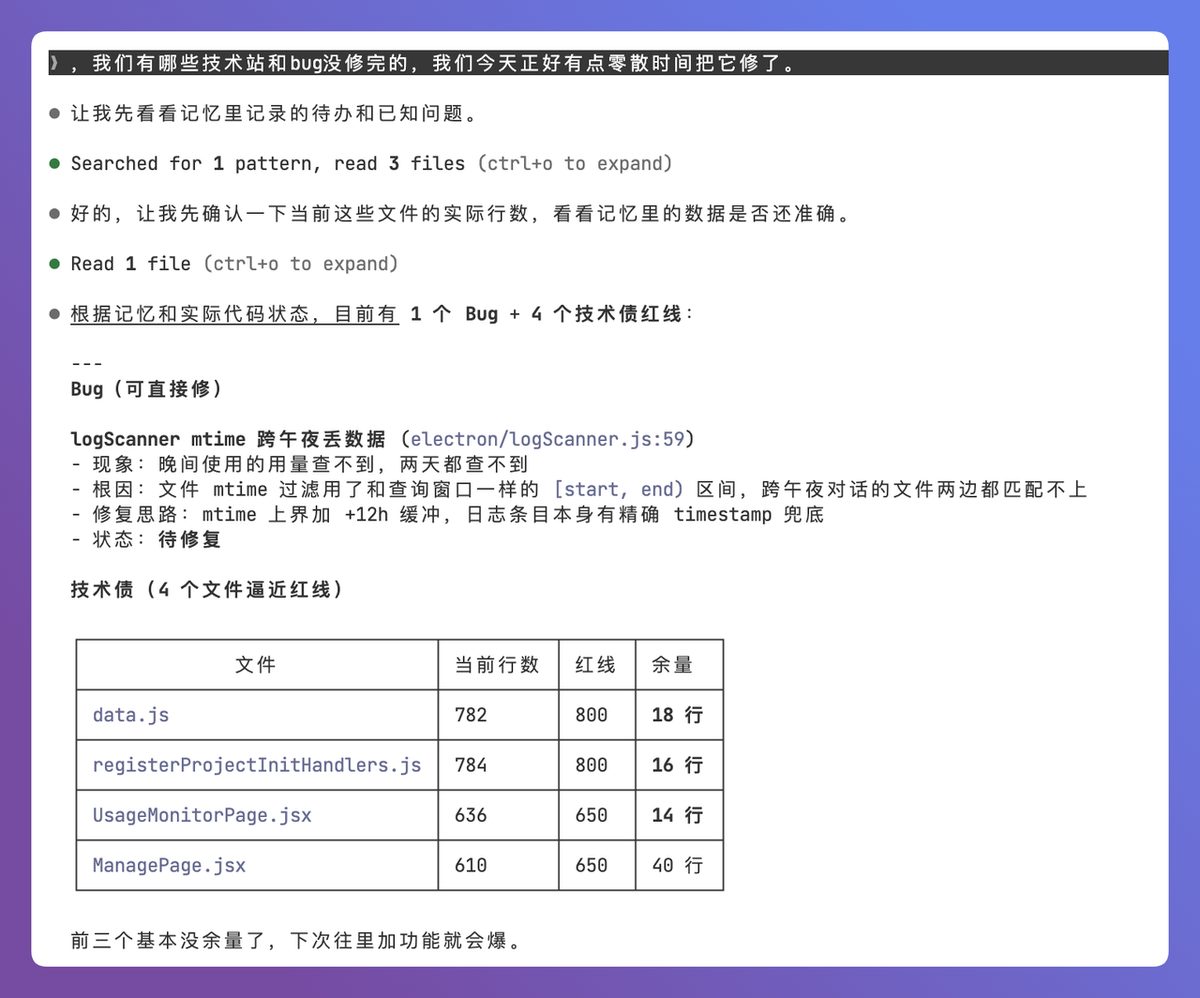
以前我每天都要先花时间想今天该干嘛,现在这一步直接没了。
从这之后我变得更懒了,进度记录都扔给了AI。
2. 复盘点评:有了记忆功能的Claude点评起来更扎心
我试着让 Claude Code 从它的视角,点评一下我最近的状态,然后它发给我下边这段内容。
Claude Code每天的记忆里都有我当天的工作总结,那些我自己没在意的细节,被它汇总成了一些结论。
不过看完了之后我真扎心了,我的执行力好像还非常有待提升。。。
如果没有这些记录,我大概率还会觉得自己挺努力的。
而且我居然没法反驳它,因为它在用数据说话。
3. 决策提醒:偏离方向时,它会拦你
在上周末我和AI讨论定下了一条决策原则:判断一件事要不要做,核心看它能不能反哺我现在的影响力路径。
这个原则,被AI记录到了记忆里。
最近我看大家都在做出海产品,于是我又跑过去兴冲冲的问Claude,要不要肝个出海产品试一试呀?
它直接拒绝了我,基于我们上周末讨论出来的原则。
那一刻我有点愣住了,我自己都忘了我跟它定了这条规则了。
人其实很容易被新机会带偏,但有一个记性很好的搭档在旁边,会在你要偏的时候,把你拉回你原本的路径上。
如果没有它提醒,这种看起来不错的新机会,我可能又会跑过去尝试一下,最后草草收场。
另外一个我觉得很好用的点是:每天对话结束后,它会帮我生成一份当天的记忆文件。
当天做了什么、讨论了什么、有哪些结论,都会被整理好写进去。
我不用自己再去做记录,它会帮我把这些过程自动沉淀下来。
看完效果,让我们来聊聊这套系统是怎么搭的。
记忆系统设计逻辑
整套记忆系统由三层内容构成,它们分别是CLAUDE.md、MEMORY.md(长期记忆)、memory/日期.md(每日记忆)。
第一层:CLAUDE.md,AI作业的规范
这是整个系统的核心,也是Claude Code每次作业都会加载的模块。
这个文件里包含:项目简介、人设规范、记忆协议三部分内容。
项目介绍主要是让Claude Code了解我们在做一个什么样的事情。
人设规范是约束Claude Code的作业逻辑,希望它能够用什么样的方式来和我们一起干活。
记忆协议是一个通用的规范,主要讲清楚长期记忆和短期记忆的区别,每次作业如何进行加载。
第二层:MEMORY.md,AI的长期记忆。
长期记忆和短期记忆最大的区别在于,它只存全局长期有效的信息。不是当天的琐碎记录,而是那些对项目长期有用、不会频繁变化的内容。
以日常工作区的长期记忆为例,我主要放的是:项目背景、内容发布流程、关键决策,以及一些个人偏好。这些信息的特点是,不常变,但一旦变化影响很大。
AI会根据每次的对话内容,判断哪些内容值得沉淀到这里。
长期记忆有一个很重要的点:一定要精简,不要什么都往里放,只保留真正长期有效的核心信息。
第三层:memory/日期.md,AI的每日记忆。
这一层存的是每天的工作记录,包括今天做了什么、讨论了什么、得出了哪些结论,以及接下来要做什么。
和长期记忆不同,这一层更像是过程记录,用来承接每天的上下文,让AI清楚当前的进度。
在实际使用中,你可以根据自己的习惯,配置AI加载历史记录的时间范围。
设计逻辑总结
这套记忆系统的设计逻辑其实比较有意思,我在做之前其实考虑过两套方案。
第一套是偏工程化的方案:通过 MCP 接口做一层封装。
每次对话结束后,让AI调用 MCP,把信息写入对应的文件目录;使用时再通过MCP读取存档,并在存档层做索引和检索逻辑,这样能够实现一套相对完整的记忆系统。
第二套方案就是现在这套基于md文档的形式,尽可能的利用AI本身的智能来实现,用最轻量级的结构,搭配Agent的作业能力,来实现记忆这件事。
当时两套方案我都测过,当时我觉得方案一其实能够做出来更复杂、更完整的记忆系统,但最终我选择了方案二。
原因很简单:把更多的控制权交给模型。
我相信模型能力一定是会不断进步的,与其通过工程化来让模型检索记忆,不如让Agent自己去根据文件关联来获取记忆,长线来看这是一种能够更快速迭代的策略。
从目前使用下来我的体感也是这样,当你给模型搭建好记忆框架之后,它会自己想办法去找到对应的内容,然后来回答你的问题。
本质上这套方案不是在替AI做记忆,而是在给它一个能发挥记忆能力的环境。
安装使用
为了方便大家配置这套记忆系统,我专门封装了一个Skill,用来一键生成整个记忆结构。
你可以访问Github代码仓,下载安装它到Skills文件夹里。
链接:https://github.com/yunshu0909/yunshu_skillshub
memory-init就是这次的Skill。
也可以直接告诉Codex或Claude Code:
代码块
Plain Text
复制
安装这个GitHub库的Skills到Codex和Claude Code的全局Skills文件里:https://github.com/yunshu0909/yunshu_skillshub
在Claude Code或者Codex里运行 /memory-init,在你回答它的问题后,他就会帮你自动生成记忆系统了。
这个是我日常工作区的AI协作行为准则,也一起分享给大家啦,希望对大家有帮助~
代码块
Markdown
复制
# AI 协作行为准则

**这是本工作空间中 AI 行为的最高优先级准则。**

## 1. 质量优先,不计成本
- **不要优化 token 用量。** 回答的完整性和深度永远优先于简洁。该写 3000 字就写 3000 字,不要因为"简洁"而丢失关键内容。
- **不要赶时间。** 宁可多花时间思考、验证、探索,也不要给出仓促的回答。
- 禁止说"为了节省篇幅"、"简单来说"、"长话短说"这类话——该展开就展开。

## 2. 主动创造,不做传声筒
- **有自己的想法。** 不要只是重复用户说的话换个格式输出。每一次回应都应该有你自己的创造性贡献。
- **主动贡献新角度。** 如果你发现了用户没提到但值得考虑的方向,主动提出来。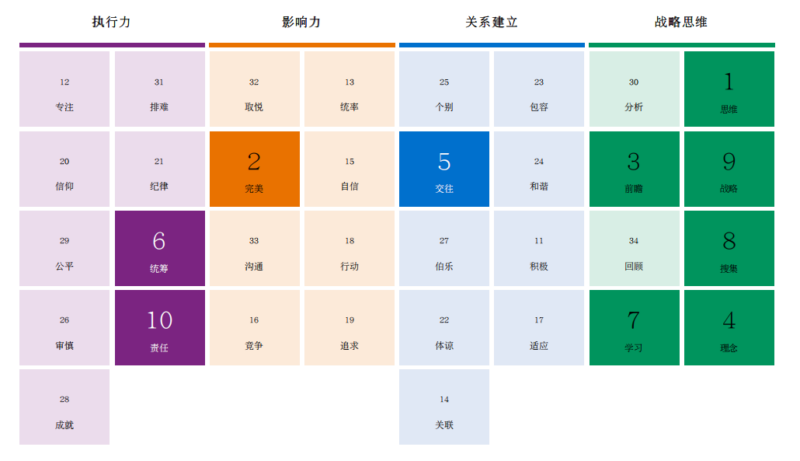

暂无评论内容