
前言
各位圈友,大家好,我是淋雨。做了十多年游戏,比较熟悉手游项目开发,网站和iOS App开发也略懂一点;这两年主要是使用AI开发单机游戏以及网站项目,面向出海领域做一些产品;
经不住生财航海的小红书项目长久持续发船,我也想学习下小红书的运营,也参加了3月的小红书航海,但并没有在航海中达到之前预设的目标。在航海结束之后,我继续研究小红书的虚拟产品,因个人需求做了个小红书选品分析工作台,使用了两个月左右,有3W+的产品入库,暂时没遇到账号问题,在此分享给大家一起生财有术。
在这个过程中我找了很多方向,每一个方向下面又有非常多的产品。
我花了几天时间,在选定的两个方向下整天去搜索商品,找关键词、记录关键词,去搜索商品看竞品,看别人的产品。这对我的选品思路有了很大的提升,发现了以前很多没有看见过的商品和新的方向。
但是刷得太多,这里面就遇到一个无法沉淀的问题。
即使我花了三天时间整天地刷,能记住的可能也只是那些让我眼前一亮的产品。至于具体的数据——比如它们的销量、店铺的笔记数量以及增长量,在我的记忆中存留的并不多。
虽然我已经关注了这些产品和店铺,但如果想从小红书收藏页面里再翻出来,是一件比较麻烦的事情。
作为程序员,很自然地就会想到,应该把这些数据沉淀下来后,然后搭建一个查询后台。通过这个后台,我们可以对数据进行统计分析,并观察一些异常指标。
这是这个选品分析工作台的起源。
通过这个方案,搭建这个后台之后,大概收集了两个月的数据,商品库有3w+的数量,目前还没有遇到账号的问题。
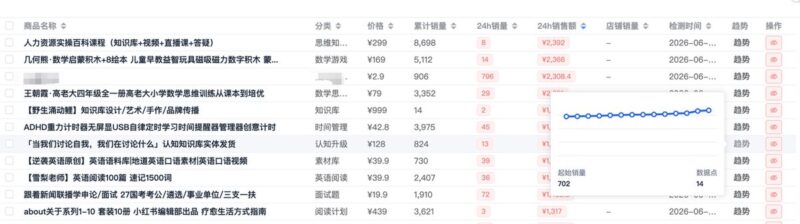
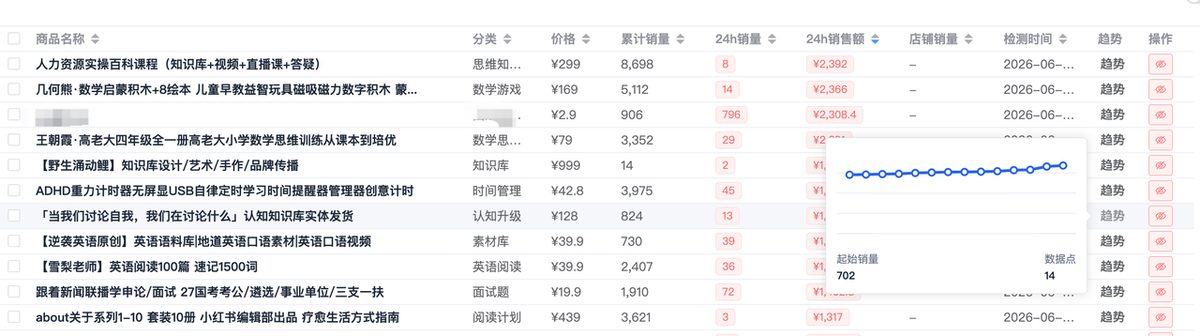
先看一下这个后台数据区域长什么样,能看到什么内容。
找现成方案
在开始之前,我去“生财有术”的帖子里面翻了帖子看有没有圈友在做这个需求。看圈友有做一个“野马”的产品,但现在已经不提供对应的服务了。
后来我也在网上搜了一下,还有像“千瓜”、“灰豚数据”之类的产品。但这些产品相对来说太重了,感觉很多功能在那时都用不上。
于是我继续在“生财”里面找帖子,看大家是怎么解决这个问题的。
翻了许多帖子,找到了一个用影刀来获取商品数据的方案。但我对影刀不太熟,而且还要安装比较重的软件,这并不是我特别喜欢的方式。但我对他通过什么技术方式来获取数据比较感兴趣,只有放狗搜了。在网上搜到一位网友发的文章,里面比较清楚地说明了怎么通过影刀来采集小红书的商品数据。
方案不合适转向研究原理
看了影刀的官方文档以及网友发的文章,最后发现它的原理其实很简单:使用脚本调用adb 在自动化测试框架(UIAutomator)的帮助下调用 开启安卓手机的开发者模式 的小红书App 来获取数据。
UIAutomator框架(Android 原生 UI 自动化测试框架)一开始也是不知道的,是 Codex 给出的这个自动化测试框架。当然现在也还有 UIAutomator2。
刚好我有一个旧手机和小号,可以用它们来试验一下。
小规模验证
现在已经有了一个别人验证过的获取数据的方式,以及一个测试环境,但是我们现在需要做一个简单的小验证,确认这个方案是可行的,在确认之前,我们不能预测这个方案可行,并进行后续的大规模开发。
这里就打开熟悉的Codex,通过和 Codex 沟通来做一个简单的 POC(概念验证Proof of Concept) 来验证这个思路。
根据和 Codex 沟通的结果,我们可以通过 ADB 和 UI Automator 这个测试框架来模拟用户进行点击搜索,然后把当前展示的页面的数据导出到我们本地,再到本地去解析出对应的商品数据。
我通过这个 POC 观察到,通过搜索能够解析出非常丰富的数据。
我们可以提取出的信息包括:
- 1. 店铺名
- 2. 商品名
- 3. 销量数值
- 4. 价格
- 5. 加购数据
当然,点商品进去之后还能获得更多的数据,比如说评价这些,但是这个效率就非常低了。而且你不可能搜索出来的每一个商品都点击进去,所以我们就只取了搜索界面上展示的数据作为数据的基础。
这里面会遇到一些技术上的问题,比如:
- 1. 页面规则不统一
生成的页面并不是完全规则的,其资源 ID(Resource ID)不太固定。
- 2. 识别偏差
有可能将搜索关键词或店铺关键词识别错误。
这时候就需要和 Codex 沟通,明确它们的展示规则,从而尽量排除这些异常数据。比如下面这些:
这种属于小红书App上导出页内容的格式发生了变化,和之前定下的解析规则不一样,这种情况下需要让 Codex 去帮助处理掉这些商品,并对这个字段增加新的解析。
在 POC 实验通过之后,我们就知道这条路是行得通的,接下来就可以开始进行工程化开发了。
工程化工具
我们需要来解决从单一的 POC 脚本,到每天可以自动化运行的工具的转变。
需要整理我们的需求:
- 1. 自动定时运行
- 2. 关键词能随时调整
- a. 当然也可以放到飞书多维表格或者是本地的 CSV。
- 4. 风控:为了尽量避免小号被封掉,我们需要对行为以及频率做个限制。
- 5. 去重:对于类似关键词可能会搜索出来一个商品,那么同店铺同商品就需要做去重。
- a. 店铺基础信息
- b. 商品信息每日快照
举个例子:
我们尽量模拟正常人的使用频率来进行搜索和翻页。不要一秒都不停留就开始下一页,这样采集效率是高了,喜提封号的效率也会提升,这种操作对小红书来说都是明显的异常信号。
在我们的第一部分需求比较明确后,我们就可以和 Codex 进行沟通,明确我的环境是什么、我的需求是什么,然后让它给你出一个你认可的方案。
至于开发语言:
- 1. 熟悉什么就用什么
- 2. 如果什么都不熟悉的话,就用 Python 吧
如果是在中途遇到什么问题,比如 ADB 连不上、找不到机器,那可能就需要去检查:
- 1. 手机是否开启了开发者模式
- 2. Codex 是否有足够的权限去使用 ADB 获取设备信息
- 3. 确认是否使用了数据线将电脑和手机连接,而不是充电线
就这样,第一版的采集器就基本上够用了,可以采集到商品数据了。
工程化数据后台
商品数据已经基本采集到数据库中了,但数据库里的数据对我们来说不直观,不能直接进行分析,因此需要对采集的数据做可视化展示。
为了方便展示我们要做一个工作台,用来对数据进行展示和分析。在继续之前,我们还是需要先做需求定义:我们有什么数据,需要看什么数据,需要分析什么?
拥有的数据
- • 店铺名、商品名、总销量(日总销量快照)、搜索关键词、价格
需要分析的数据
- 1. 高GMV产品
- 2. 日增GMV>1000的产品
有了拥有的数据和我们想要分析的目标之后,接下来对于数据后台的需求就比较明确了。
数据后台需求分析
简单列一下工作台至少需要包含的内容:
- a. 关键词在后台进行配置
- b. 关键词采集搜索页的数量
- c. 翻页间隔
- i. 很多商品实际上是没有销量的,采集回来的意义不大,所以需要做一个简单策略,对这些商品提前停止采集。
- i. 在指定页数以内,如果它的销量还是很高,需要继续增加动态翻页的数量,同时设置一个上限。
- i. 工具或者apk在采集过程中可能会中断或者崩溃,需要支持断点恢复
- ii. 这里还需要做一个抉择:之前断掉的那个关键词是否还需要继续采集?
- a. 产品池
- b. 高GMV产品池
- c. 日增GMV>1000 的产品池
这里比较重要的就是日增 GMV 的产品,我们需要关注的主要是这个数据下的产品,部分高GMV产品它有可能是很长时间积累的,用来做参考的意义就不大。而我们通过日增GMV商品,我们可以找到一些新的爆款商品,以及观察到常青树的商品。
如果有些需求并不在我们的可视范围内,可以尝试去提取已有产品中对我们有价值的内容,转化为我们的需求。
AI协同搭建数据后台
现在我们基本的需求和数据都准备好了,接下来需要和 AI 共同搭建这个数据后台网站,便于后续进行分析。
网站简单来说主要由三个部分组成:前台页面(我们看见的内容)、后端(业务逻辑和API 接口)、数据库。
开发框架的话,我们直接使用 Next.js 来进行开发,做过 Web开发 和参加过航海网站开发的圈友应该都对这个比较熟悉了,AI 工具的话还是用我们熟悉的 Codex。
这里顺便介绍下Next.js,Next.js 是基于 React 的全栈框架。对我们这个场景来说,它最大的好处是前端页面和后端接口可以写在同一个项目里——你想查数据库、想做几个展示页面,不用再单独起一个后端服务,一套代码全搞定,对一个人开发的自用工具来说省事很多。
把我们上面的需求方案以及数据和我们的要求,直接给Codex,让它帮助我们制定一个开发方案:
经过一段时间的处理后 AI给了我一份方案:
还有一个方案是,可以把我们设计的需求发送给 Claude design,让它根据需求帮助设计几个界面,然后把需求和界面给 Codex让它设计一个具体的开发方案,这样开发出来的内容可能更符合需求。
具体来说,我们会把页面拆分成:
- 1. 商品页
- 2. 店铺分析页
- 3. 异常值观察页(即日增观察页)
- 4. 销量常青页面(GMV一直保持一个速度增长)
到这一步时,我们就可以让 AI 来进行开发,这是开发完成之后的效果(自用就没有去做 UI 界面上的美化了)
上面只是一些基础性的玩法,当我们在有了这些商品数据之后,我们还有什么玩法?就是在不做工作台的情况下,我们可以直接让Claude Code/Codex 帮助我们做数据分析,比如说分析商品类别的体量、价格带、竞品数量、不同店铺的日增销量等。
总结
我要解决什么问题
花了很长时间刷小红书看产品,但最终因为商品数据无法沉淀,导致后续分析出现问题。所以我需要把看到的商品信息记录下来,便于后续的分析和选品。
不要直接开工开发
在已经成熟的领域里做产品,我们遇到的问题,大概率其他人可能已经遇到过并解决了。当遇到问题的时候,不能直接依赖自己的程序员的底子,想着自己通过 AI 工具来做点什么来解决这个问题,而是应该先去找有没有现成的解决方案,这个方案是不是符合我们的需求,能不能尽量贴合我们的需求,而不是花几天时间从头来解决这个问题。如果能贴合我们的需求,那尽量用现成的方案。因为自己开发一个,中间可能会有很多坑需要去踩,而且花的时间也不少,最后做出来的内容可能还不一定让自己满意。
与AI协作先完成最小验证
在没有现成的解决方案的情况下,我们需要和 AI 一起完成方向的探索之后,再继续考虑是不是能把这个工具进行工程化。在做成具体产品的时候,一定是 POC 先行。
这个项目真正想验证的不是"能不能获取小红书商品数据",而是"作为独立开发者,面对一个真实需求时,正确的动作顺序是什么":先定义问题 → 找现成方案 → 没有再最小验证 → 验证通过才工程化。AI 让每一步都变快了,但顺序错了,快只会让你更快地浪费时间。
使用高质量的AI开发工具让每个人都可以将工作流整合成为自用工具(保守一点自用,稍微花点心思就可以做成产品了),只要敢想敢上手,AI就敢帮你实现!

暂无评论内容